8 Definición actualizada y didáctica del gen
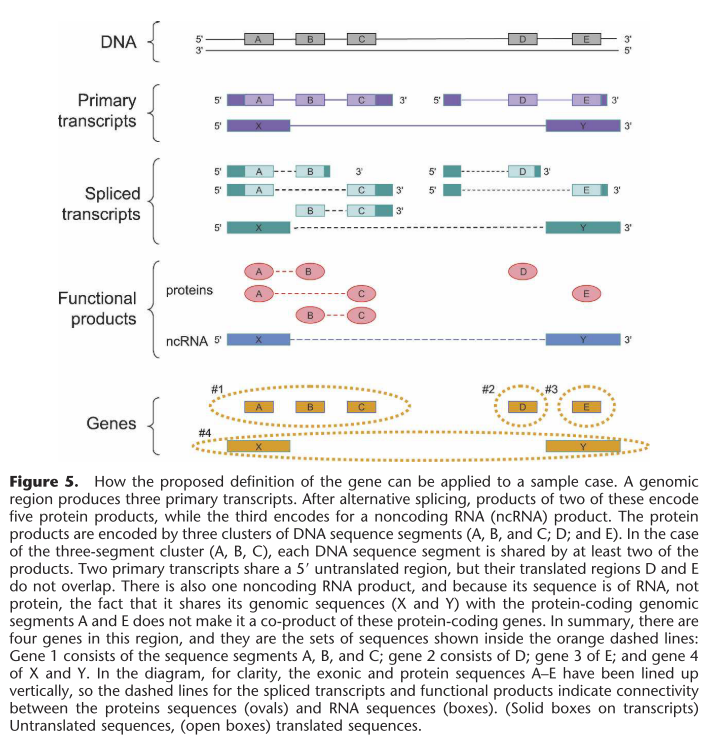
Un gen es una unión de secuencias genómicas que codifican un conjunto coherente de productos funcionales potencialmente superpuestos
y en casos simples es considerado: un gen es una secuencia de ADN que codifica un producto proteico o de ARN (mRNA o no codificante).
8.1 Potencial codificante
El potencial codificante se refiere a la capacidad de una secuencia de ADN o ARN para ser traducida en una proteína funcional. Se evalúa mediante características como la presencia de codones de inicio y parada, la longitud del marco de lectura, la conservación evolutiva y el uso de codones típico de genes.
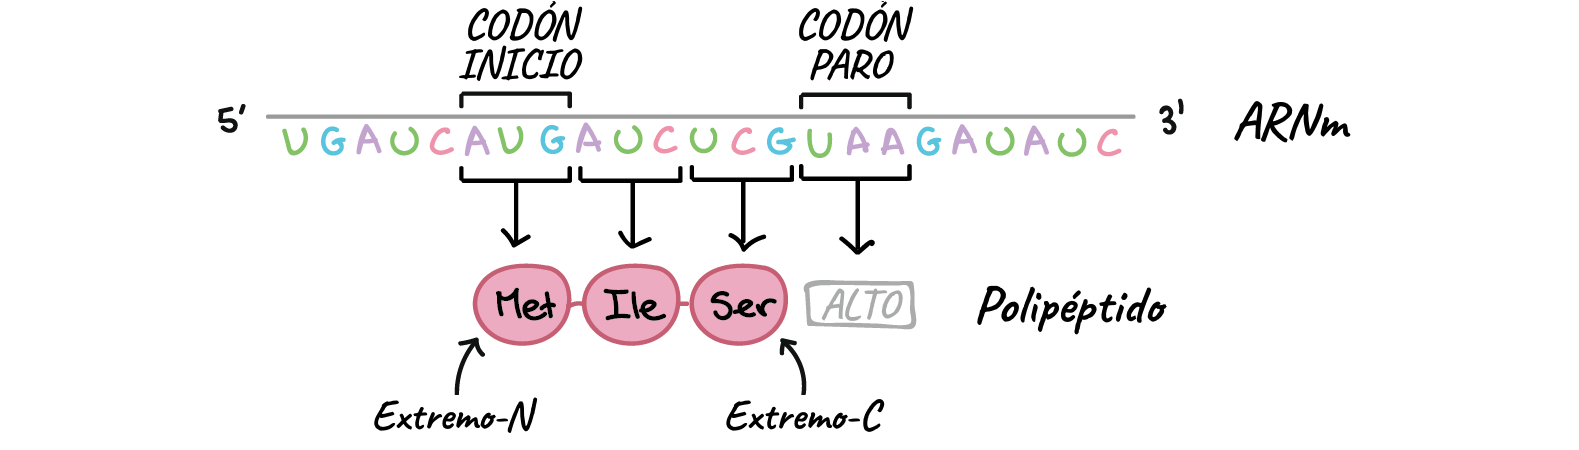
8.2 Marco de lectura abierto (ORF)
Un marco de lectura abierto (ORF) es una secuencia de nucleótidos que comienza con un codón de inicio (generalmente AUG) y termina con un codón de paro (UAA, UAG o UGA), sin interrupciones que impidan la traducción. Es una señal estructural que sugiere que la región podría codificar una proteína, aunque no garantiza funcionalidad.
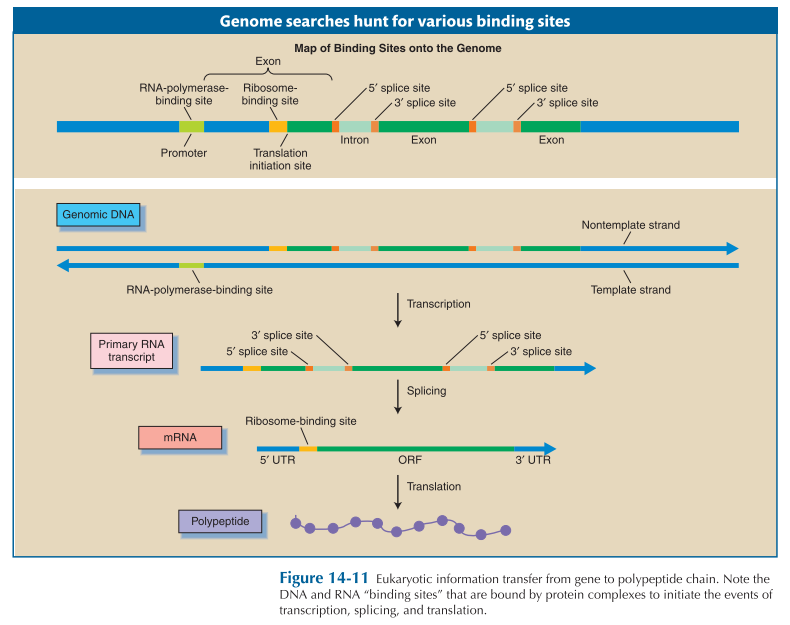
- No todos los ORFs son funcionales: algunos pueden ser artefactos o pseudogenes.
- En transcriptómica y metagenómica, se usan algoritmos para predecir genes basados en ORFs y potencial codificante.
8.3 ¿Cómo distinguimos transcritos codificantes de no codificantes?
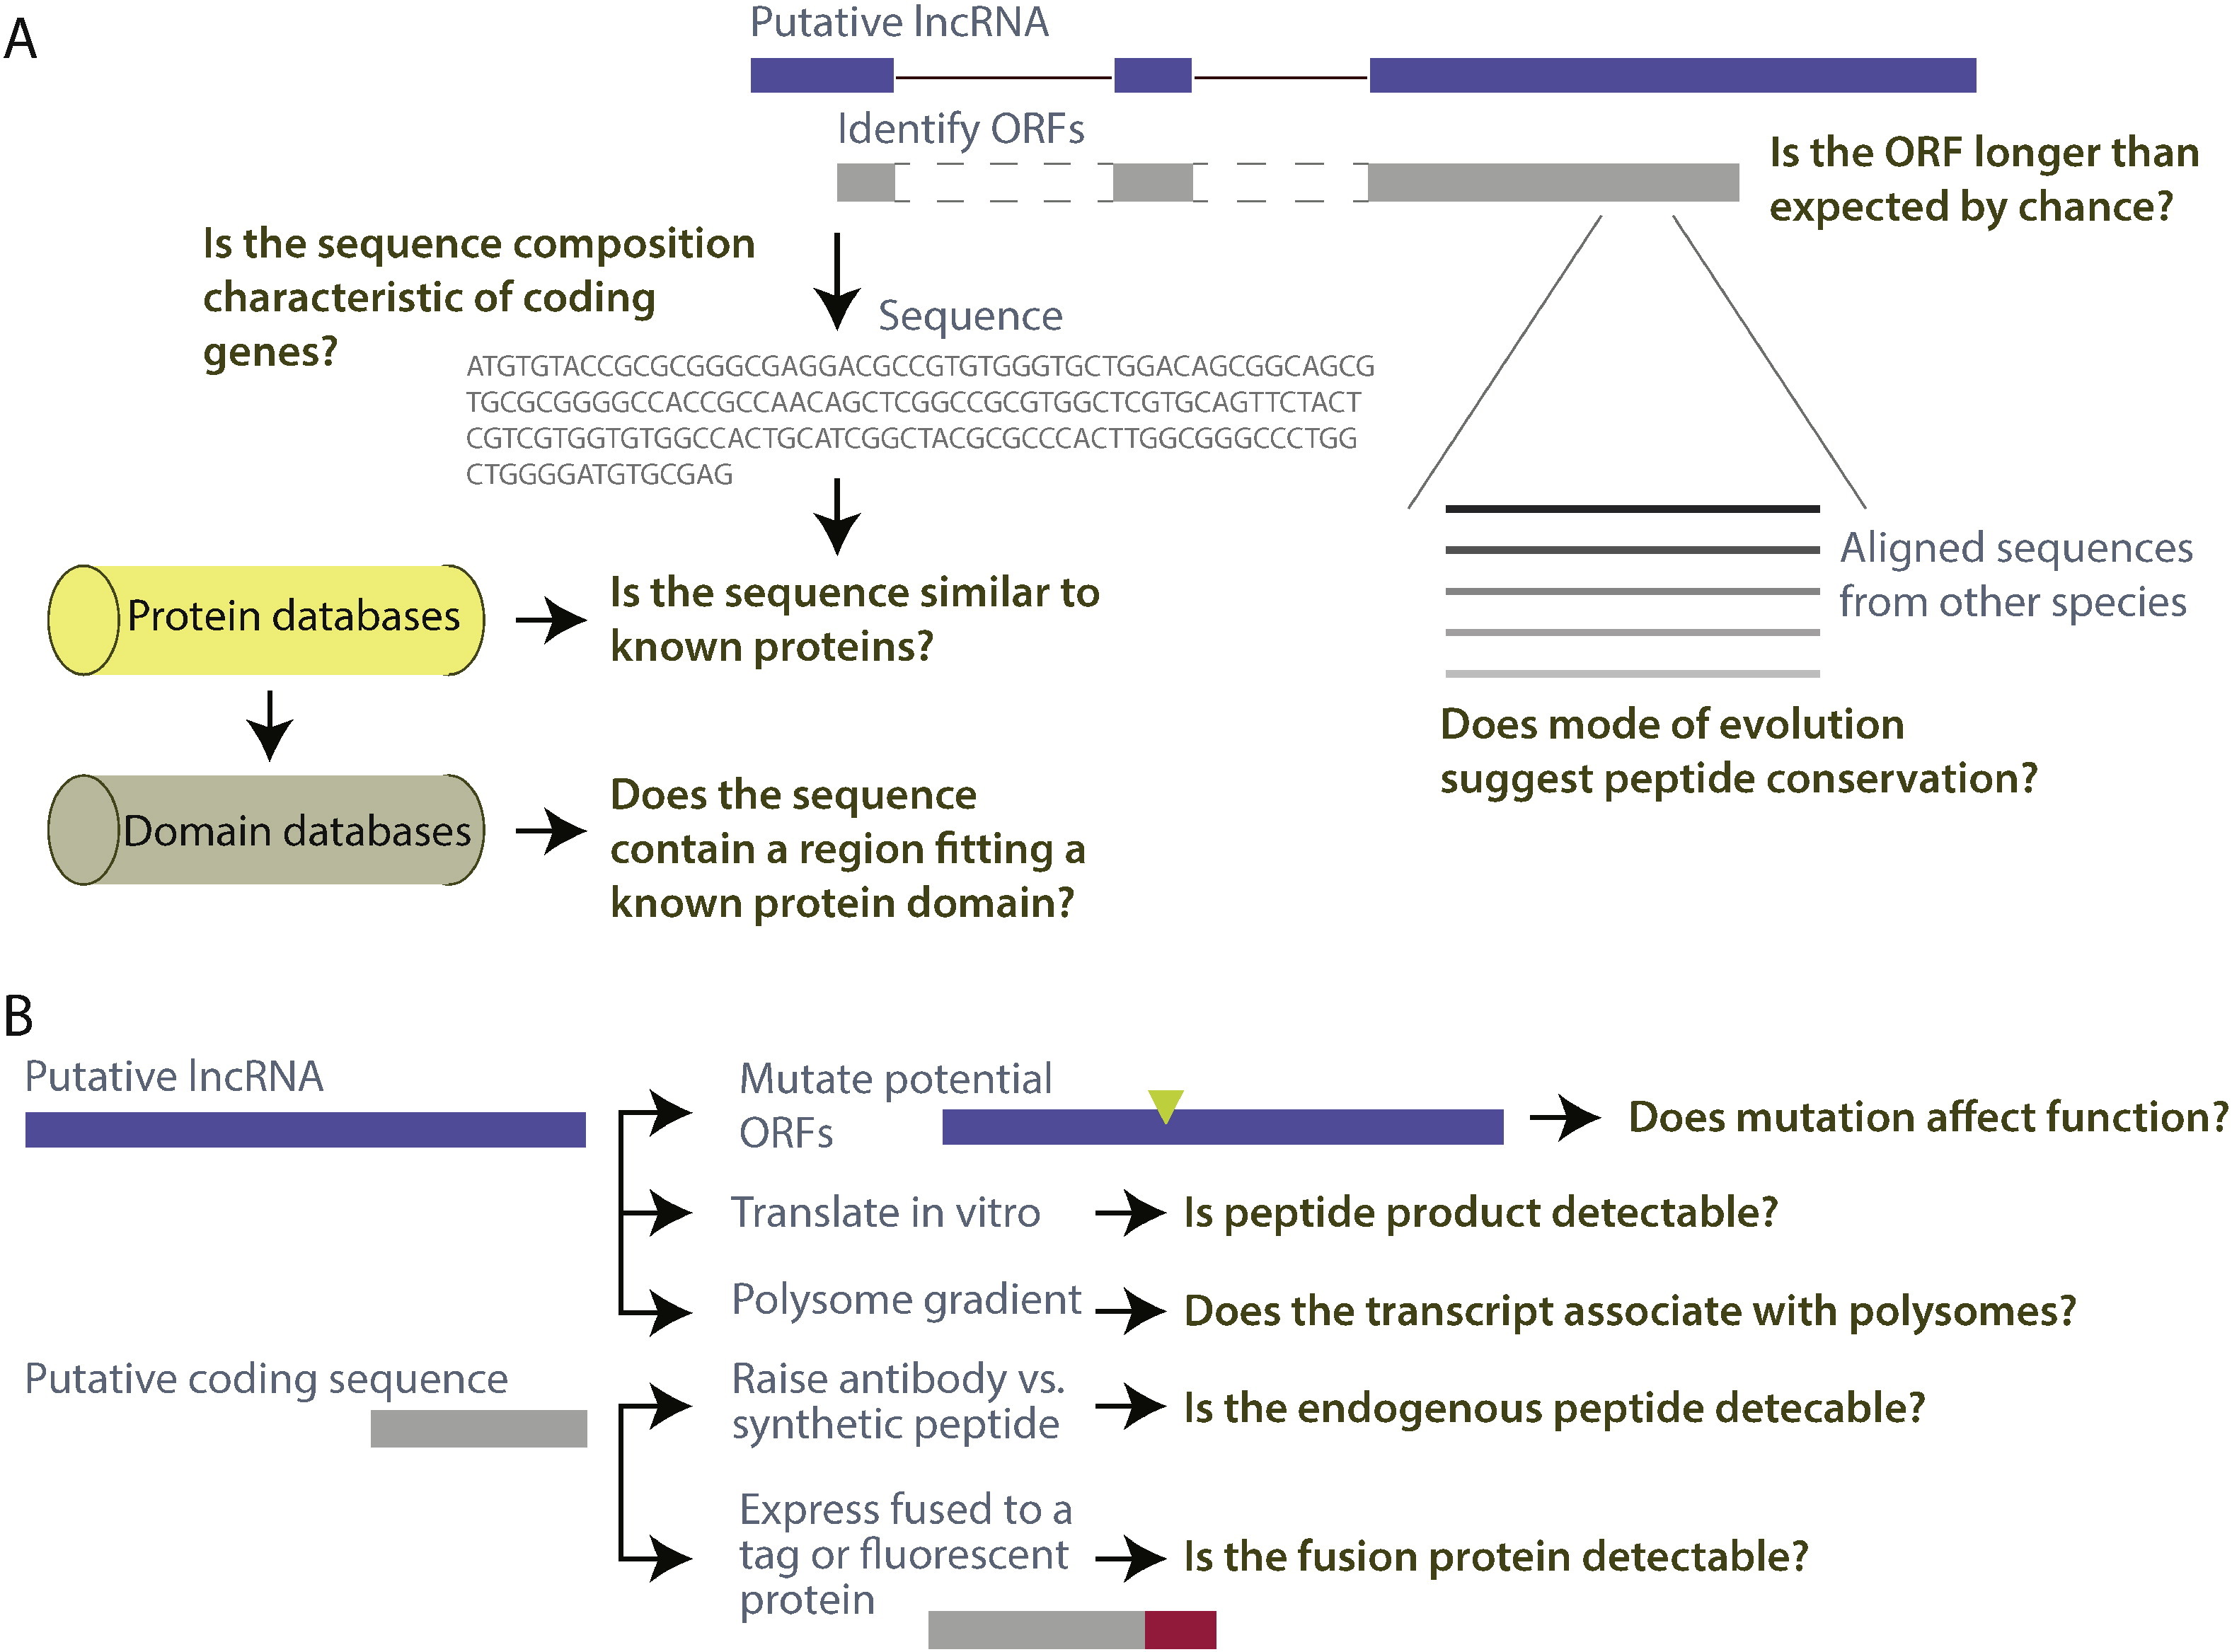
La distinción entre transcritos codificantes y no codificantes es esencial para la anotación funcional del transcriptoma. Aunque los lncRNAs no codifican proteínas, es necesario descartar evidencia de codificación antes de clasificarlos como tales.
8.3.1 Tipos de archivos comunes en bioinformática
| Formato | Descripción | Empleo | Ejemplo |
|---|---|---|---|
FASTA (.fasta / .fa) |
Contiene secuencias de nucleótidos o aminoácidos. Cada entrada inicia con > seguido de un identificador. |
Genoma de referencia, proteínas, transcriptos/nucleótidos | |
FASTQ (.fastq) |
Similar a FASTA pero incluye calidad de lectura por base (lecturas de secuenciación). | esencial en pipelines de secuenciación (RNA-seq, WGS). | |
GTF/GFF (.gtf / .gff) |
Archivos de anotación genómica: definen genes, exones, intrones, etc. | clave para anotación estructural y funcional. | |
BED (.bed) |
Define regiones genómicas (intervalos), útil para visualización y análisis de cobertura. | Localización de genes, clasificación de genes, visualización (IGV, UCSC Genome Browser) | |
8.3.2 Herramientas clave en bioinformáticas
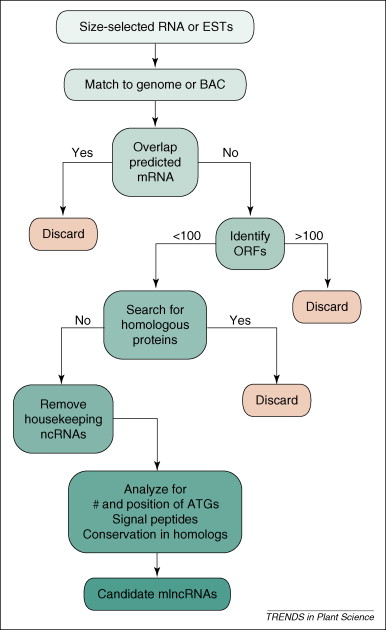
Aquí les dejo el link al Método de selección de lncRNAs empleado en Arabidopsis thaliana. Relacionado con el artículo Transcriptome-guided annotation and functional classification of long non-coding RNAs in Arabidopsis thaliana.
| Software | Propósito | Función | Secuencia de interés (input) | Base de datos |
|---|---|---|---|---|
gffread |
Obtener el FASTA de las secuencias seleccionadas | gffread |
Archivo de anotación (GTF) y genoma de referencia (FASTA) | NA |
EMBOSS/v6.6.0 |
Obtener el tamaño de las secuencias | infoseq |
Secuencias/nucleótidos (FASTA) | NA |
kentUtils/v302 |
Extraer la secuencia FASTA a partir de IDs y Generar archivo BED a partir del GTF | faSomeRecords, gtfToGenePred y genePredToBed |
Secuencias/nucleótidos (FASTA) y IDs. Archivo de anotación (GTF) y genoma de referencia (FASTA) |
NA |
TransDecoder |
Predicción del ORF y la “proteína” codificada | TransDecoder.LongOrfs y TransDecoder.Predict |
Secuencias/nucleótidos (FASTA) | NA |
blastn |
Comparación con proteínas conocidas | blastn |
proteína (.pep) |
UniProtKB/Swiss-Prot (proteínas) |
blastp |
Comparación con proteínas conocidas | blastp |
Secuencias/nucleótidos (FASTA) | UniProtKB/Swiss-Prot (nucleótidos) |
blastx |
Comparación con proteínas conocidas | blastx |
nucleótidos (traducidos) | UniProtKB/Swiss-Prot (proteínas) |
blastdbcmd |
Extraer información de la base de datos de BLAST | blastdbcmd |
IDs de las secuencias | RefSeq non-redundant proteins |
SignalP |
Predicción de péptidos señal | signalp |
proteína | NA |
TMHMM |
Predicción de dominios transmembranales | tmhmm |
proteína | NA |
Phobius |
Predicción de dominios transmembranales y péptidos señal | phobius.pl |
proteína | NA |
HMMER |
Búsqueda de dominios conservados | hmmscan |
proteína | Pfam |
Infernal |
Busca coincidencias estructurales en secuencias usando modelos de covarianza y escanea bases de datos | cmsearch |
Secuencias/nucleótidos (FASTA) | Rfam |
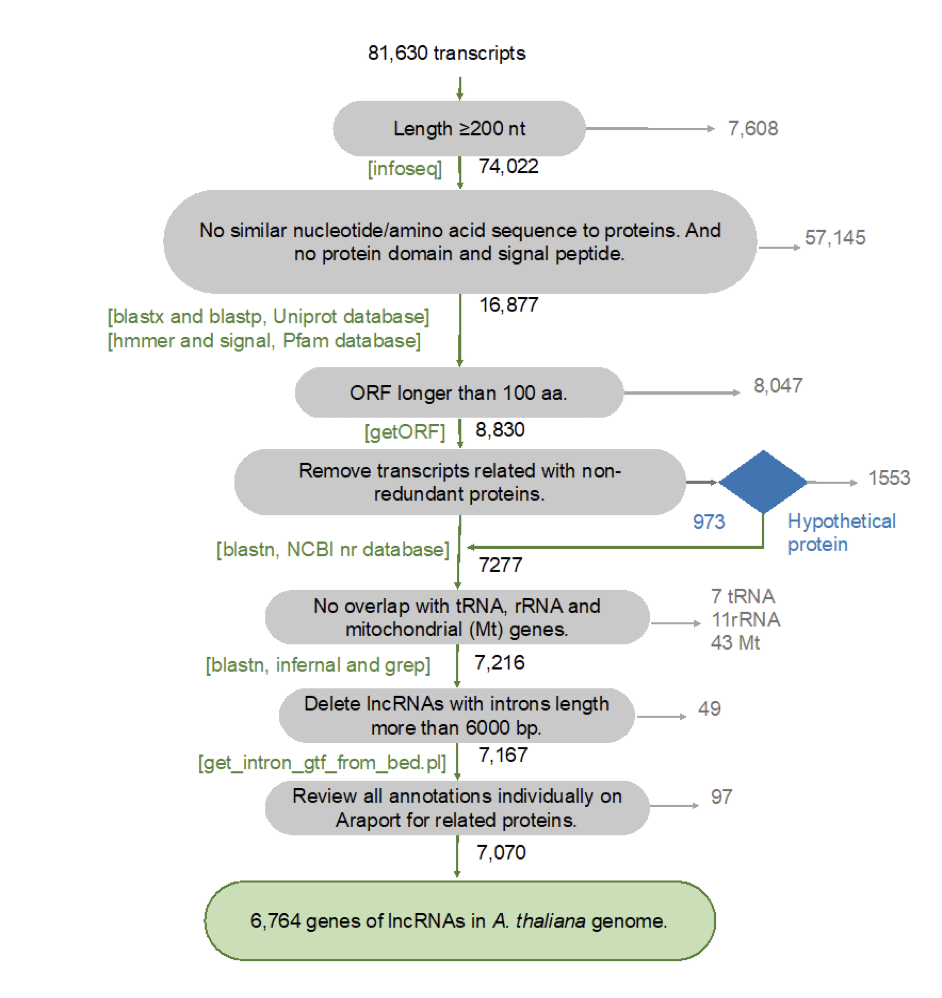
Si el transcrito no tiene similitud con proteínas conocidas, no contiene péptido señal, no tiene dominios transmembranales, y no presenta dominios conservados, es probablemente no codificante.
Si alguno de estos elementos está presente, se debe considerar como potencialmente codificante y excluirlo de la clasificación como no codificante.