23 Encontrar patrones con grep
Fecha: 29 de septiembre, 2026
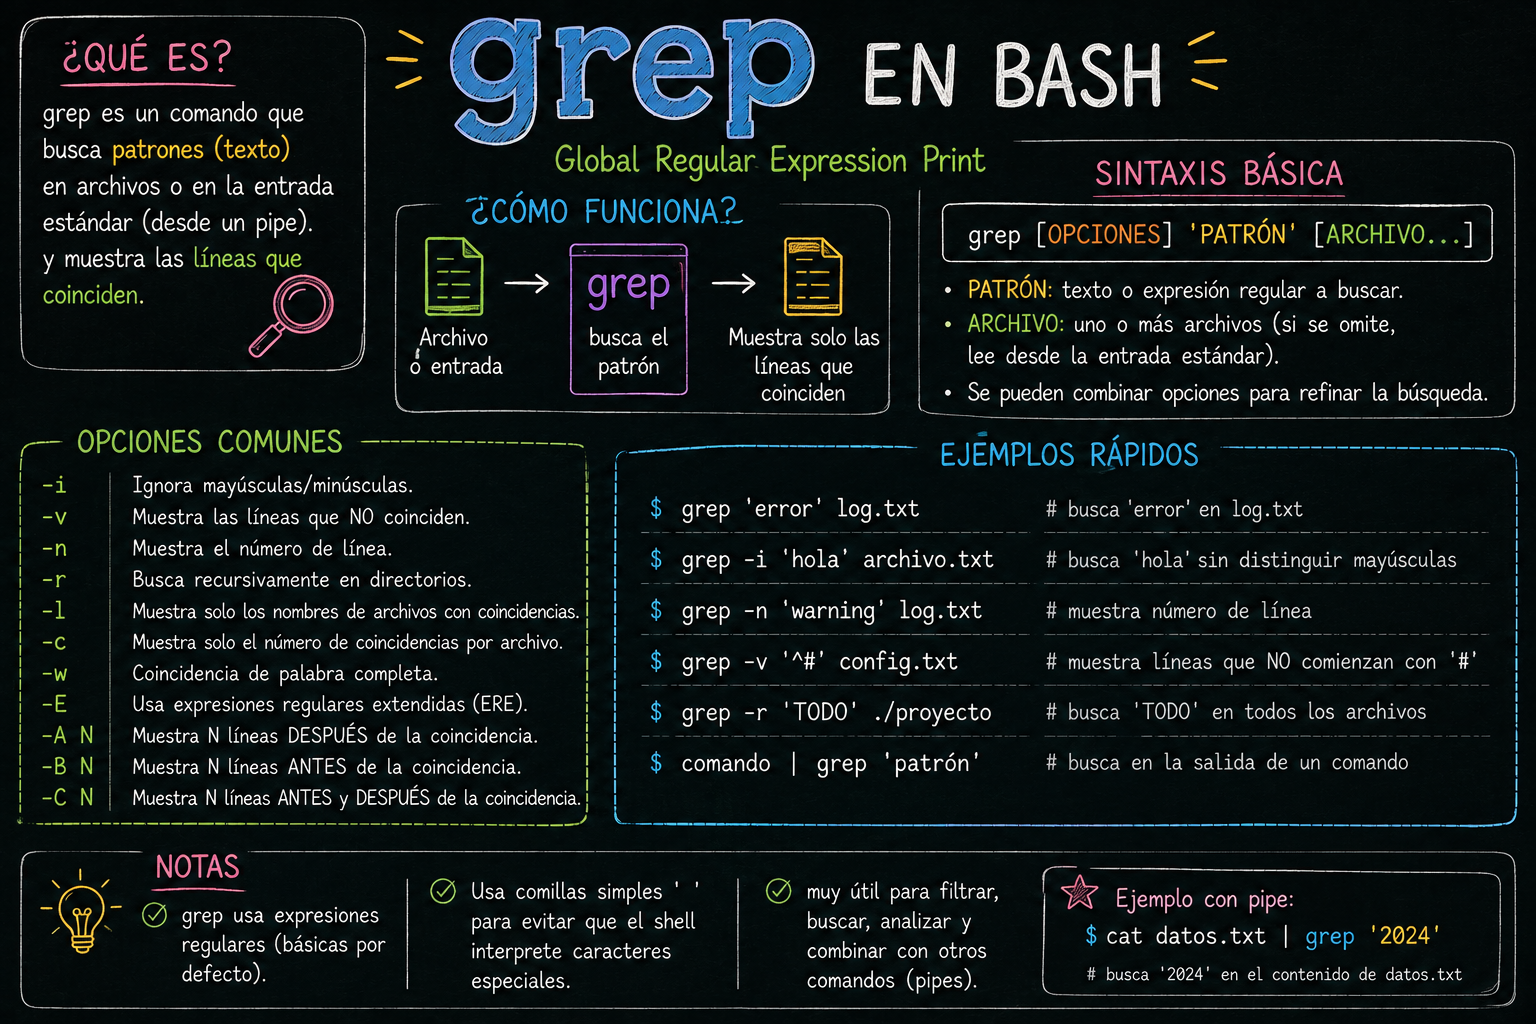
grep es un comando de Linux/Unix que sirve para buscar patrones de texto dentro de archivos o en la salida de otros comandos. Su nombre viene de “Global Regular Expression Print” y es una de las herramientas más usadas para filtrar información rápidamente.
23.1 ¿Qué hace grep?
- Buscar cadenas: encuentra líneas que contienen una palabra o frase específica.
- Usar expresiones regulares: permite patrones avanzados como
a+b,^inicio,fin$. - Filtrar resultados: se puede combinar con otros comandos usando
|(pipe). - Opciones comunes:
-i→ ignora mayúsculas/minúsculas.-v→ excluye coincidencias.-r→ busca recursivamente en directorios.-n→ muestra el número de línea.-E→ activa expresiones regulares extendidas.
23.2 Opciones principales de grep
Genera este primer archivo para los ejercicios:
echo -e "ab\na+b\nab\naab\nAnaplasma\naaab\nHola mundo\nhola estudiantes\nHOLA UNIVERSO" > archivo.txt
cat archivo.txt
1. -E - Expresiones regulares extendidas
Permite usar metacaracteres avanzados como +, ?, |, { }, *.
# Sin -E: no funciona
grep "a+b" archivo.txt      # Busca "a+b" literal

# Con -E: funciona
grep -E "a+b" archivo.txt   # Busca "a", "ab", "aab", "aaab", etc.
Genera este archivo:
echo -e "ac\nabc\nabbc\nabbbc\nabbbbc\nadc\nabdc\nab\nbc" > regex.txtPregunta primero: ¿Qué líneas creen que coincidirán con ab*c?
grep -E "ab*c" regex.txt # Significa a + cero o más "b" + c
grep -E "ab+c" regex.txt # + exige al menos una b
grep -E "ab?c" regex.txt # cero o una "b"
grep -E "ab{2}c" regex.txt # a seguido de 2 "b" y 1 c
grep -E "ab{2,}c" regex.txt # 2 "b" o más
grep -E "ab{2,4}c" regex.txt # De 2 a 4 "b"
grep -E "(ab)+" regex.txt #Agrupamiento, que aparezca ab juntas
grep -E "a.{3}" regex.txt # a seguido de 3 caracteres cualesquiera
grep -E "[abc]{3}" regex.txt # Quiero 3 caracteres, que pueden ser a,b, o c| REGEX | 0 b |
1 b |
2 b |
3+ b |
|---|---|---|---|---|
ab*c |
✅ | ✅ | ✅ | ✅ |
ab+c |
❌ | ✅ | ✅ | ✅ |
ab?c |
✅ | ✅ | ❌ | ❌ |
2. -i - Ignorar mayúsculas/minúsculas
grep -i "hola" archivo.txt
# Encuentra: "Hola", "HOLA", "hola", "HoLa"
Ahora genera este otro archivo:
echo -e "INFO: El sistema inició correctamente.\nERROR: No se pudo abrir el archivo.\nINFO: Conexión establecida.\nWARNING: Memoria baja.\nERROR: Fallo en la base de datos.\nINFO: Proceso terminado." > archivo.log
cat archivo.log
3. -v - Invertir búsqueda (líneas que NO coinciden)
grep -v "ERROR" archivo.log
# Imprime todas las líneas que NO contienen "ERROR"
4. -c - Contar coincidencias
grep -c "ERROR" archivo.log
# Output: 2 (número de líneas con "ERROR")
5. -n - Mostrar número de línea
grep -n "ERROR" archivo.log
# Output:
# 2:ERROR: No se pudo abrir el archivo.
# 5:ERROR: Fallo en la base de datos.
6. -l - Mostrar solo nombres de archivos que contienen la palabra
grep -l "ERROR" *.log
# Output: archivo.log
7. -r - Buscar recursivamente en directorios
grep -r "ERROR" /var/log/
# Busca en todos los archivos del directorio /var/log/
8. -o - Mostrar solo la parte que coincide + -i para ignorar las mayúsculas
grep -oi "hola" archivo.txt
# Output:
# Hola
# hola
#HOLA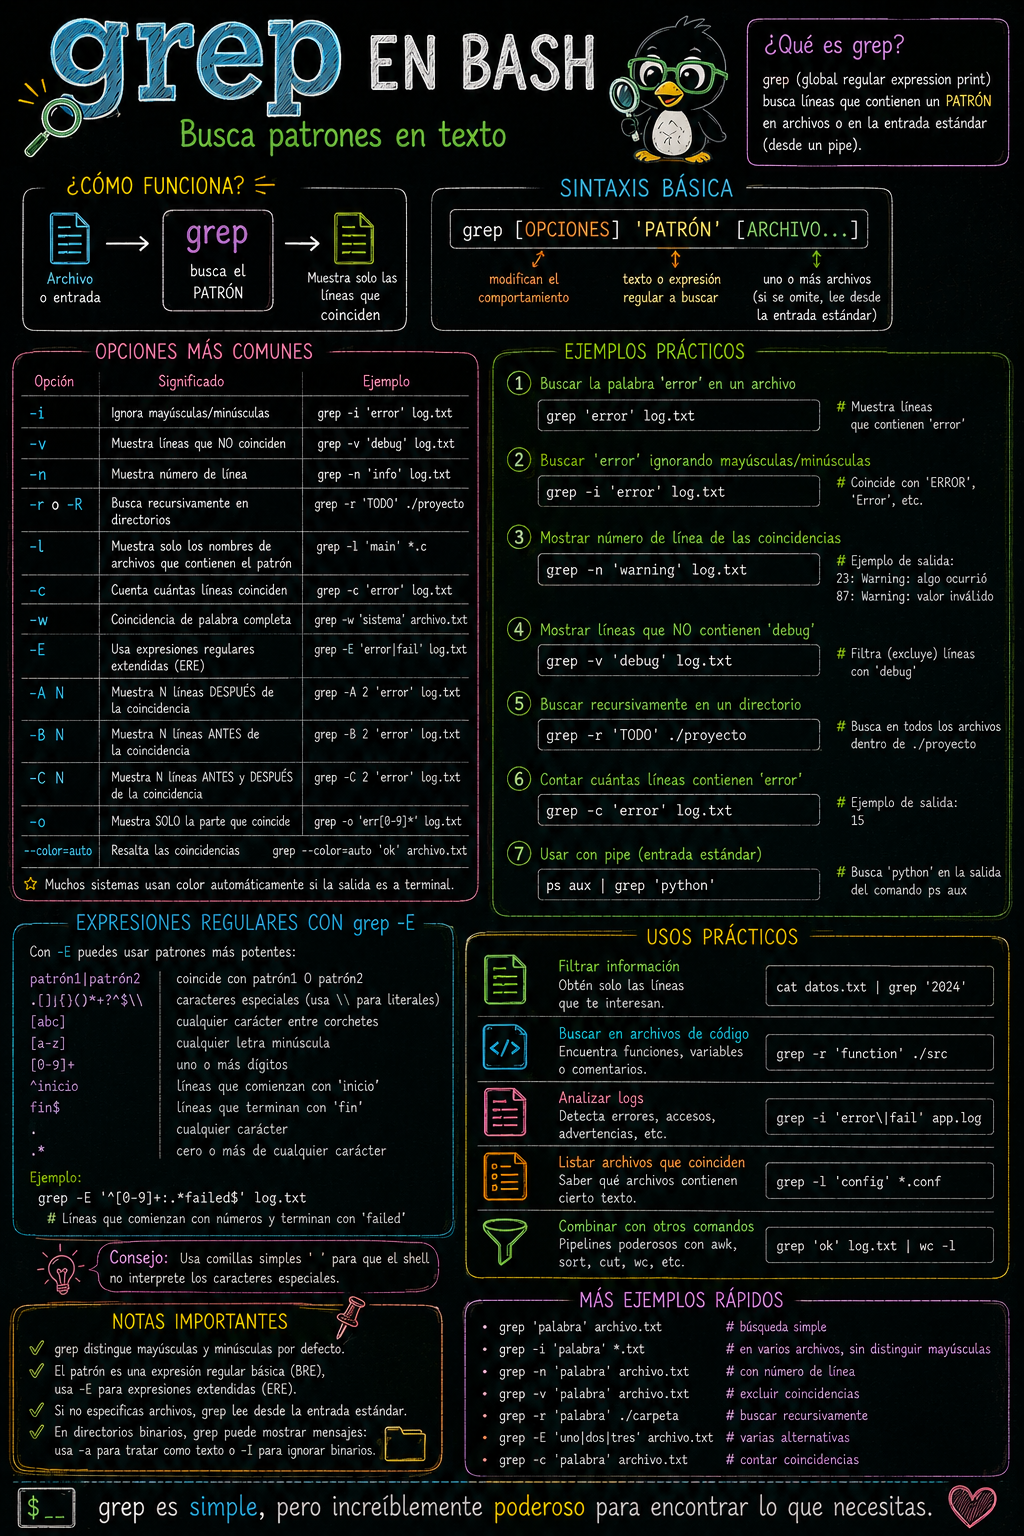
23.2.1 Ejercicio 5 - Dominar grep (con echo -e)
- Crea los archivos que usaremos y verificar su contenido en este ejercicio:
# Crear directorio de trabajo
mkdir ejercicio_grep
cd ejercicio_grep

# Crear archivo de usuarios
echo -e "juan@ejemplo.com 25 activo\nmaria@empresa.es 30 inactivo\ncarlos123 28 activo\nana@dominio.org 22 activo\npedro@test 35 inactivo\nsofia@dominio.com 27 activo\nluis@empresa.es 40 inactivo" > usuarios.txt
cat usuarios.txt

# Crear archivo de log
echo -e "[2024-01-15 10:30:45] [INFO] Sistema iniciado\n[2024-01-15 10:31:12] [ERROR] Conexión fallida a base de datos\n[2024-01-15 10:32:00] [WARNING] Memoria disponible baja\n[2024-01-15 10:33:45] [ERROR] Archivo no encontrado: config.ini\n[2024-01-15 10:34:20] [INFO] Proceso de sincronización completado\n[2024-01-15 10:35:10] [ERROR] Timeout en conexión remota\n[2024-01-15 10:36:00] [WARNING] Espacio en disco bajo\n[2024-01-15 10:37:30] [INFO] Backup completado exitosamente" > sistema.log
cat sistema.log

# Crear archivo de productos
echo -e "001 Laptop Dell 1200.50 disponible\n002 Mouse Logitech 25.99 disponible\n003 Teclado Mecánico 89.99 agotado\n004 Monitor LG 350.00 disponible\n005 Webcam HD 45.50 disponible\n006 Auriculares Sony 150.00 agotado\n007 Cable HDMI 12.99 disponible\n008 Hub USB 35.75 disponible" > productos.txt
cat productos.txt

# Crear archivo de emails
echo -e "juan.perez@ejemplo.com\nmaria_lopez@empresa.es\ncarlos.garcia@test.com\nana.martinez@dominio.org\npedro123@invalid\nsofia.rodriguez@empresa.es\nluis_fernandez@test.org\ncontacto@empresa.es" > emails.txt
cat emails.txt

# Crear archivo de géneros bacterianos
echo -e "Rickettsia\nOrientia\nWolbachia\nAegyptianella\nAnaplasma\nCowdria\nEhrlichia\nNeorickettsia\nCaedibacter\nHolospora\nLyticum\nOdyssella\nSymbiotes\nTectibacter" > bacterias_generos.txt
cat bacterias_generos.txt
Buscar los usuarios activos dentro del archivo
usuarios.txt. NOTA:\bno representa un carácter real, sino una posición en el texto donde termina o comienza una palabra.Buscar los errores en el archivo log
sistema.log.Buscar productos disponibles en el archivo
productos.txt.Ignorar las mayúsculas/minúsculas (
-i) de la palabra error del archivosistema.log.Contar el número (
grep -c) de usuarios activos en el archivousuarios.txt.Dime en que líneas (
grep -n) aparece la palabra ERROR ensistema.log.Mostrar solo las coincidencias (
grep -o) con la palabra ERROR ensistema.log.Buscar las especies que comienzan con A en el archivo
bacterias_generos.txt.Buscar las especies que comienzan con R o W en el archivo
bacterias_generos.txt.
23.3 Ejercicios de repaso
Puedes seguir repasando y aprendiendo de las expresiones regulares en la pagina de RegexOne.
Rangos comunes:
[a-z]= letras minúsculas[A-Z]= letras mayúsculas[0-9]= dígitos[a-zA-Z]= letras (mayúsculas y minúsculas)[a-zA-Z0-9]= letras y dígitos
El operador > sobre escribe archivos. Ten cuidado al usarlo para que no pierdas datos.
23.4 Material suplementario
- RSG Ecuador. Scripts en Bash
- RSG Ecuador. Wildcards y Streams
- RSG Ecuador. Expresiones regulares (regex)
- Wildcard Selection in Bash
- Expresiones regulares