Cómo usar las funciones del paquete
get_heatmap_mat(), create_heatmap(), process_go() y reduce_go_terms()
2026-10-31
Source:vignettes/articles/functions_es.Rmd
functions_es.RmdBienvenida
Además de los datos, GeneExprLupusMx incluye cuatro
funciones que se usan a lo largo de las lecciones. Esta guía muestra
cómo usarlas con tus propios datos, paso a paso y con
ejemplos que puedes copiar.
| Función | ¿Para qué sirve? | Se usa en |
|---|---|---|
get_heatmap_mat() |
Convierte un DESeqDataSet en una matriz de z-scores
lista para un heatmap
|
Lección 3 |
create_heatmap() |
Dibuja un heatmap de ComplexHeatmap con una
anotación de color; se pueden apilar varios |
Lección 3 |
process_go() |
Reduce los términos GO redundantes de un archivo de enriquecimiento y grafica los términos padre | — |
reduce_go_terms() |
Aplica process_go() a todos los
archivos de enriquecimiento de una carpeta |
— |
Lo que necesitas saber antes: haber hecho las lecciones De las cuentas de RNA-seq a la exploración de datos (VST y z-scores) y Funciones biológicas de los genes diferencialmente expresados (enriquecimiento funcional).
Tiempo estimado: 45 minutos.
Glosario
-
VST (variance stabilizing transformation):
transformación de
DESeq2que hace que la varianza no dependa de la expresión media. - z-score: cuántas desviaciones estándar se aleja un valor del promedio del gen; permite comparar genes con niveles de expresión distintos.
- Similitud semántica: qué tan parecidos son dos términos GO según su posición en la jerarquía de Gene Ontology.
- Término padre: el término que representa a un grupo de términos GO parecidos.
- Treemap: gráfica de rectángulos anidados; aquí, cada rectángulo es un término y el color indica su término padre.
1. Preparación
library(GeneExprLupusMx) # datos y funciones del paquete
library(DESeq2)          # objeto DESeqDataSet
library(ComplexHeatmap)  # heatmaps
library(dplyr)           # manipulación de tablas

# Objetos grandes del paquete: se descargan solo la primera vez (ver ?download_data)
dds <- download_data("dds")
Colores (los mismos de las lecciones):
2. get_heatmap_mat(): del DESeqDataSet a
los z-scores
get_heatmap_mat() recibe un DESeqDataSet y
hace tres cosas:
- Aplica la transformación VST.
- Quita los genes sin variación entre las muestras.
- Convierte cada gen a z-scores y ordena las columnas como le indiques.
Usamos el checkpoint dds y nos quedamos con los
monocitos. Como el subconjunto tiene un solo tipo celular, cambiamos el
diseño a ~ Group:
mo <- dds[, dds$Cell_type == "monocyte"]
design(mo) <- ~ Group # un solo tipo celular: solo comparamos grupos

mo_order <- colnames(mo)[order(mo$Group)] # primero los controles, después las pacientes
mo_mat <- get_heatmap_mat(mo, sample_order = mo_order)

dim(mo_mat)        # genes x muestras
#> [1] 13569    33
round(mo_mat[1:3, 1:4], 2)
#>          QR011_0 QR013_0 QR022_0 QR024_0
#> A1BG         0.6   -0.11    0.56   -0.20
#> A1BG-AS1     0.6    0.45   -2.51   -0.21
#> A2M         -0.2    0.48    2.84    0.30
Cada fila tiene promedio 0 y desviación estándar 1:
summary(round(rowMeans(mo_mat), 10))
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
#>       0       0       0       0       0       0
summary(apply(mo_mat, 1, sd))
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
#>       1       1       1       1       1       1
Con tus datos: cualquier DESeqDataSet
funciona. El argumento sample_order es opcional; si no lo
das, las columnas quedan en el orden del objeto.
3. create_heatmap(): un heatmap listo para
combinar
create_heatmap() dibuja la matriz con
ComplexHeatmap, agrega una barra de color a la derecha (por
ejemplo, el color del tipo celular) y permite dividir las columnas con
split. Graficamos los genes estimulados por interferón
(ISG) de la lección 2 en los monocitos, divididos por grupo:
isg_extended <- c("IFI27", "IFI44L", "IFI44", "USP18", "IFI6", "ISG15", "MX1", "RSAD2", "IFIT1", "OAS1")

ht_mo <- create_heatmap(mo_mat[isg_extended, ],
                        color = cell_color[["monocyte"]],
                        split = mo$Group[match(mo_order, colnames(mo))])
draw(ht_mo)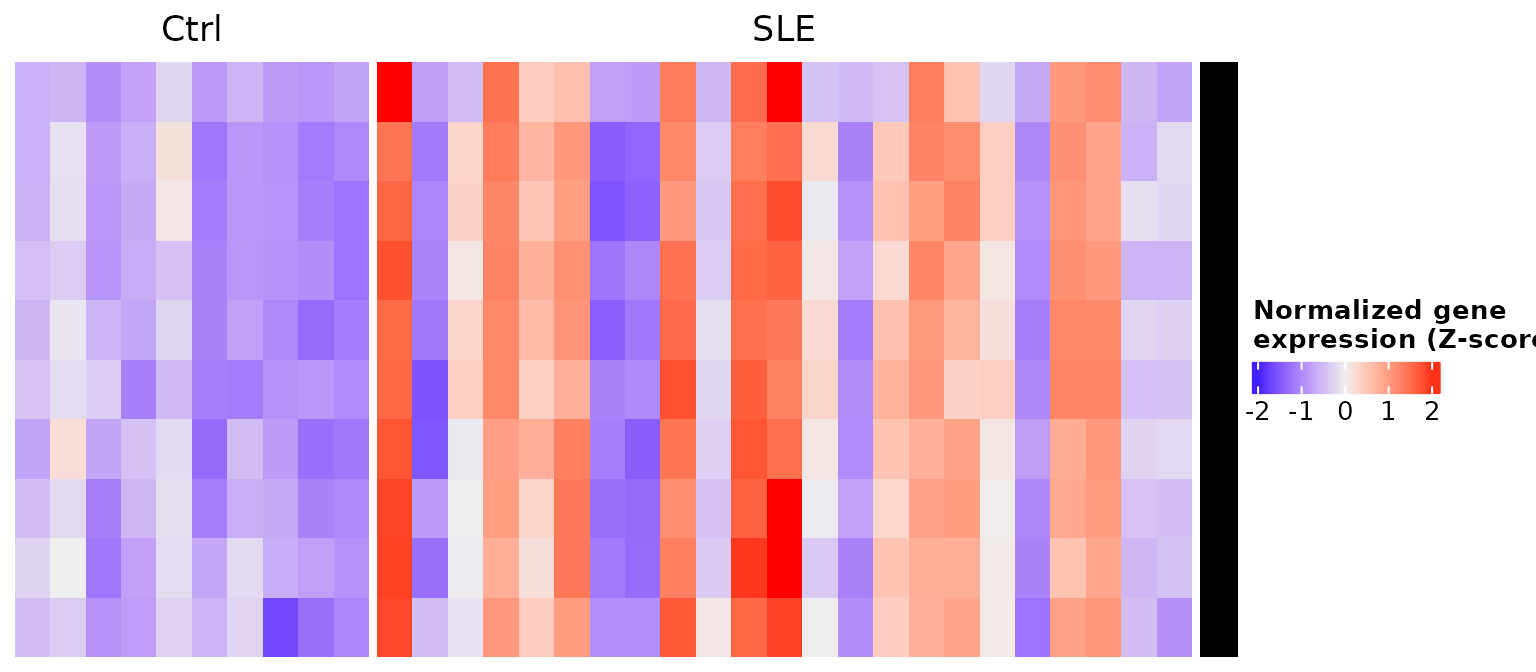
La función no muestra los nombres de los genes, para que funcione
igual con miles de genes. Como devuelve un objeto Heatmap,
puedes combinarlo con otras piezas de ComplexHeatmap; por
ejemplo, agregar los nombres con una anotación de texto:
draw(ht_mo + rowAnnotation(gene = anno_text(isg_extended)))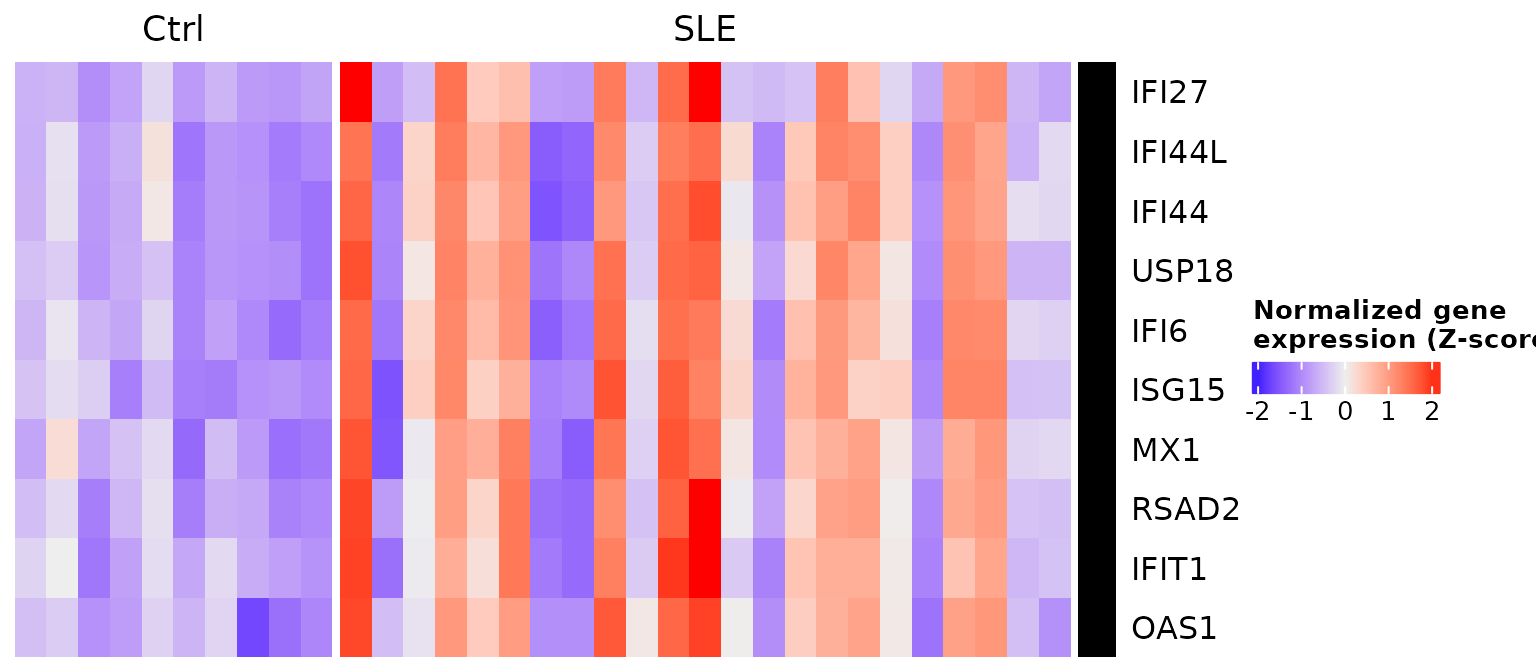
3.1 Apilar varios heatmaps
La ventaja de create_heatmap() es que los
heatmaps tienen el mismo formato y se pueden
apilar con %v%. Para eso, las columnas
deben ser las mismas en todos: usamos el identificador de cada
voluntaria (la parte de sample_ID antes del guion bajo) y
el mismo orden en los tres tipos celulares.
volunteer_order <- unique(sub("_.*", "", mo_order)) # mismo orden de voluntarias para todos

isg_mats <- lapply(c("monocyte", "moDC", "tolDC"), function(cell) {
  sub_dds <- dds[, dds$Cell_type == cell]
  design(sub_dds) <- ~ Group
  mat <- get_heatmap_mat(sub_dds)
  colnames(mat) <- sub("_.*", "", colnames(mat)) # QR011_0 -> QR011
  mat[isg_extended, volunteer_order]
})
names(isg_mats) <- c("monocyte", "moDC", "tolDC")
sapply(isg_mats, dim)
#>      monocyte moDC tolDC
#> [1,]       10   10    10
#> [2,]       33   33    33
group_split <- volunteer_info$Group[match(volunteer_order, volunteer_info$Volunteer_ID)]

ht_list <- create_heatmap(isg_mats$monocyte, cell_color[["monocyte"]], group_split) %v%
  create_heatmap(isg_mats$moDC,  cell_color[["moDC"]],  group_split) %v%
  create_heatmap(isg_mats$tolDC, cell_color[["tolDC"]], group_split)
draw(ht_list)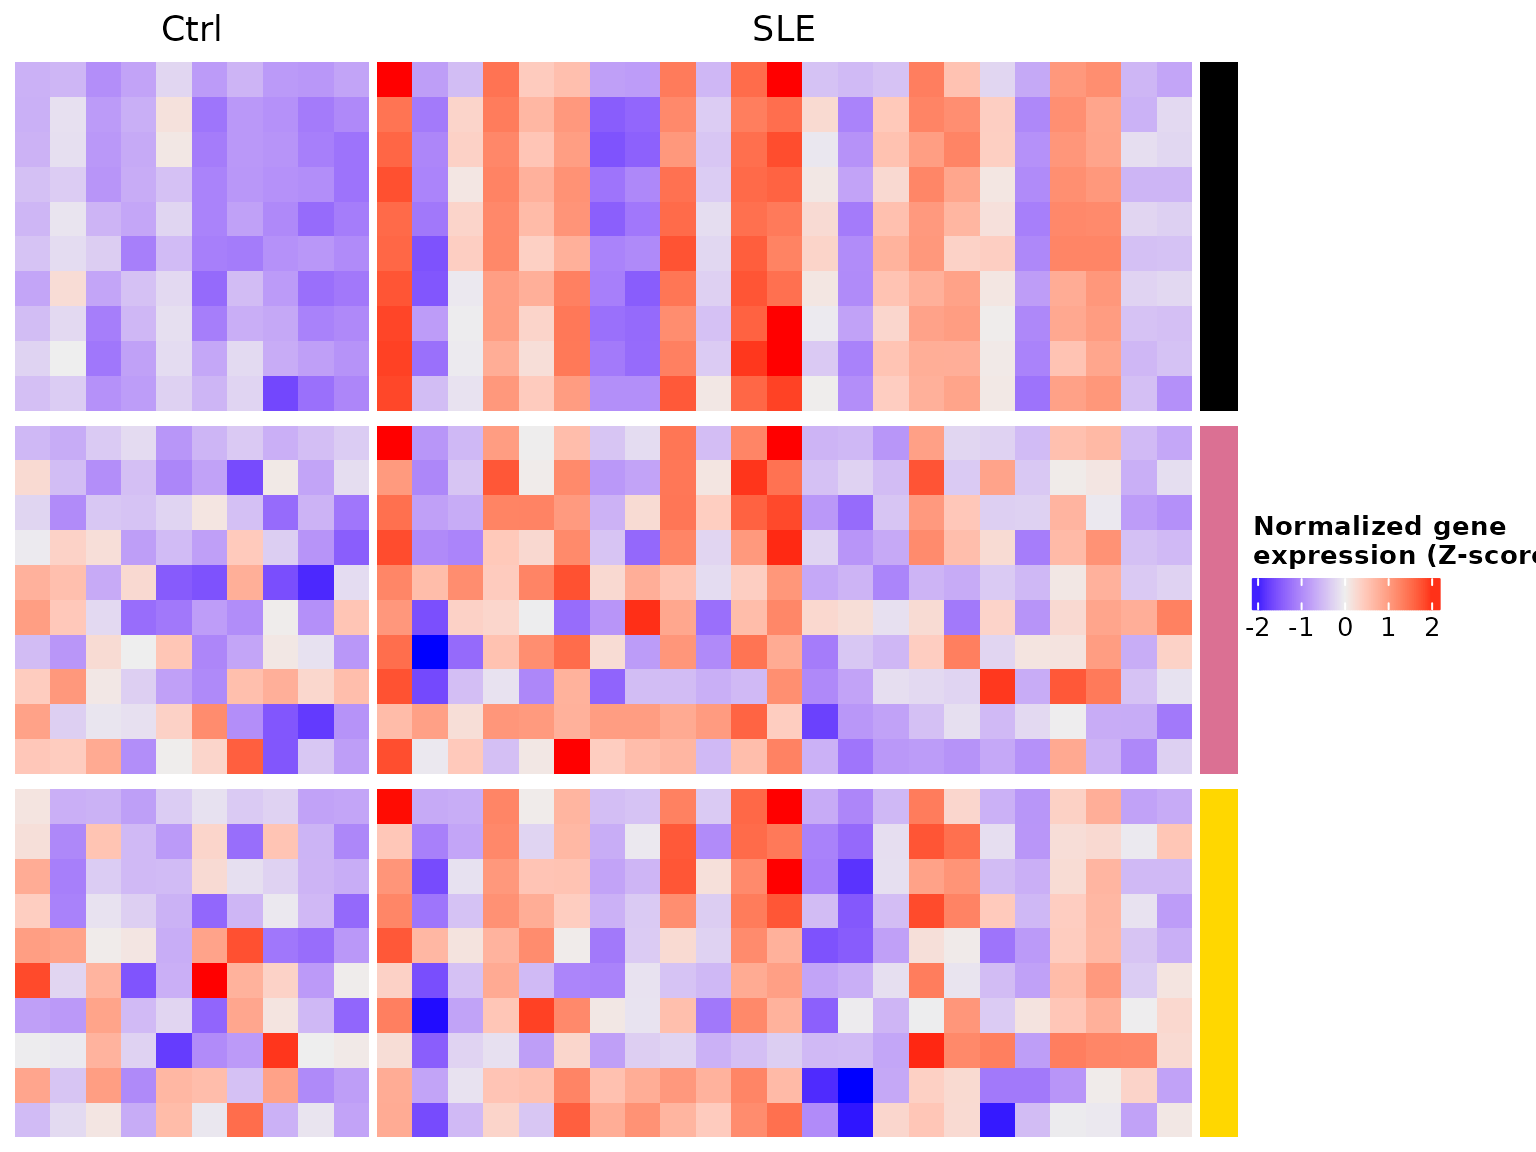
Los ISG están altos sobre todo en los monocitos de algunas pacientes (bloque negro, columnas SLE), como vimos en la lección 2.
Reto 1. Haz un heatmap de las tolDC con los
genes de síntesis de colesterol de la lección 7 (CYP51A1,
MSMO1, MVD, IDI1,
EBP, STARD4), dividido por grupo.
Ver solución
chol_genes <- c("CYP51A1", "MSMO1", "MVD", "IDI1", "EBP", "STARD4")

tol <- dds[, dds$Cell_type == "tolDC"]
design(tol) <- ~ Group
tol_order <- colnames(tol)[order(tol$Group)]
tol_mat <- get_heatmap_mat(tol, sample_order = tol_order)

ht_tol <- create_heatmap(tol_mat[chol_genes, ], color = cell_color[["tolDC"]],
                         split = tol$Group[match(tol_order, colnames(tol))])
draw(ht_tol + rowAnnotation(gene = anno_text(chol_genes)))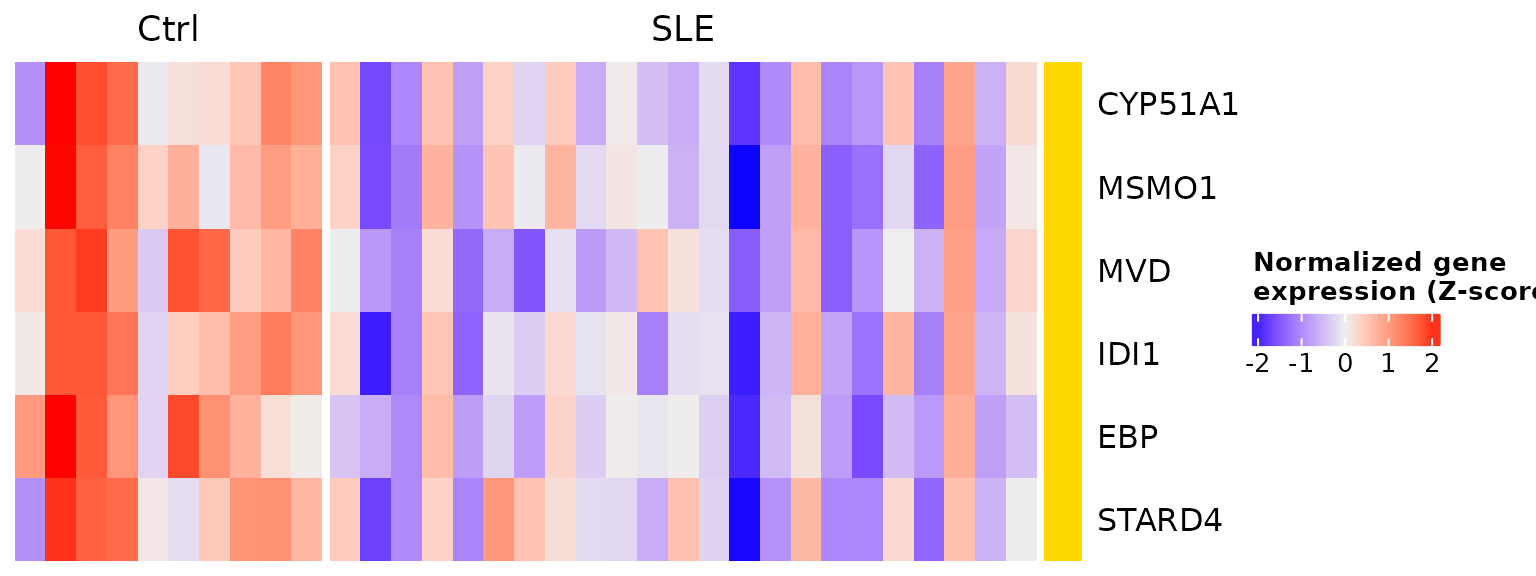
En las tolDC de las pacientes estos genes tienden a estar más bajos: es la menor inducción de la síntesis de colesterol que encontramos en la lección 7.
4. process_go(): reducir términos GO redundantes
Un análisis de enriquecimiento suele devolver cientos de
términos GO, muchos casi iguales (“response to virus”, “defense
response to virus”…). process_go() usa el paquete
rrvgo para agruparlos por similitud
semántica y resumirlos en términos padre.
La función lee un archivo .RData que contenga
una sola tabla con tres columnas:
| Columna | Contenido |
|---|---|
go_id |
Identificador del término (GO:0051607) |
term |
Nombre del término |
p.adjust |
Valor p ajustado |
El nombre del archivo debe seguir el patrón
UP_GO_<nombre>.RData o
DOWN_GO_<nombre>.RData. Preparamos uno con los
términos GO:BP de los genes que suben en
los monocitos de las pacientes (checkpoint go_results de la
lección 4):
go_dir  <- file.path(tempdir(), "go_input")   # archivos de entrada
out_dir <- file.path(tempdir(), "go_output")  # resultados .RData
fig_dir <- file.path(tempdir(), "go_figures") # gráficas
for (d in c(go_dir, out_dir, fig_dir)) dir.create(d, showWarnings = FALSE)

go_table <- go_results %>%
  filter(query == "SLE_UP_monocyte", source == "GO:BP") %>%
  transmute(go_id = term_id, term = term_name, p.adjust = p_value)
nrow(go_table)
#> [1] 183

save(go_table, file = file.path(go_dir, "UP_GO_monocyte.RData"))
Ahora ejecutamos process_go(). Necesita al menos 40
términos GO distintos; si hay menos, omite el archivo:
process_go(f = file.path(go_dir, "UP_GO_monocyte.RData"),
          direction = "UP", outdir = out_dir, figdir = fig_dir)
La función guarda dos archivos .RData y dos
gráficas:
list.files(out_dir)
#> [1] "geneListAndGOterms_UP_monocyte.RData"
#> [2] "reducedTerms_simMatrix_UP_monocyte.RData"
list.files(fig_dir)
#> [1] "GOTerm_UP_ReducedBar_monocyte.png" "GOTerm_UP_Treemap_monocyte.png"
reducedTerms contiene cada término con su
término padre:
load(file.path(out_dir, "reducedTerms_simMatrix_UP_monocyte.RData"))
reducedTerms %>%
  dplyr::count(parentTerm, sort = TRUE) %>%
  head(5)
#>                                                     parentTerm  n
#> 1                                 type I interferon production 34
#> 2                                response to type I interferon 27
#> 3                                   response to other organism 19
#> 4                                    defense response to virus 15
#> 5 pyrimidine deoxyribonucleoside diphosphate metabolic process 13
Los 179 términos se resumen en 21 términos padre, encabezados por la producción y la respuesta a interferón tipo I: la firma de interferón de los monocitos de las pacientes.
Además de guardarlas como PNG en figdir, puedes rehacer
las gráficas directamente desde reducedTerms. El
treemap muestra todos los términos, coloreados por su término
padre:
rrvgo::treemapPlot(reducedTerms)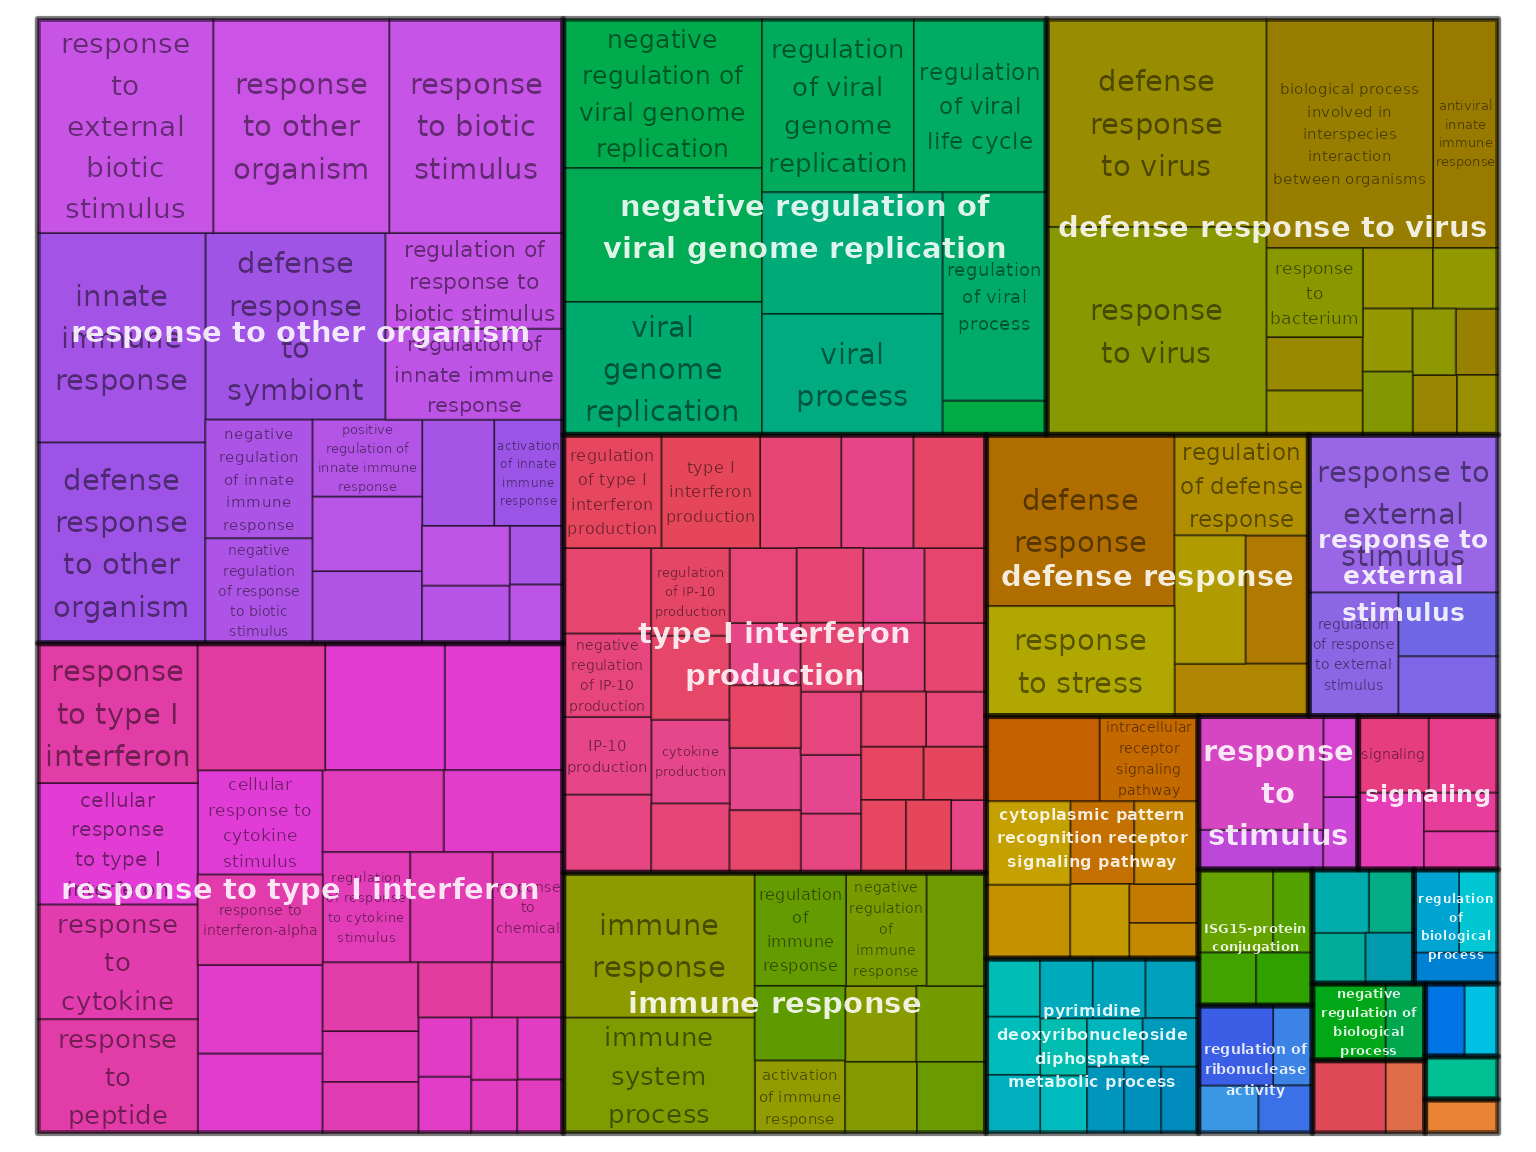
La gráfica de barras muestra cuántos términos agrupa cada término padre:
library(ggplot2)
reducedTerms %>%
  dplyr::count(parentTerm, name = "count") %>%
  ggplot(aes(x = reorder(parentTerm, count), y = count)) +
  geom_col(fill = "firebrick") +
  coord_flip() +
  labs(x = "Término padre", y = "Número de términos similares") +
  theme_minimal(base_size = 12)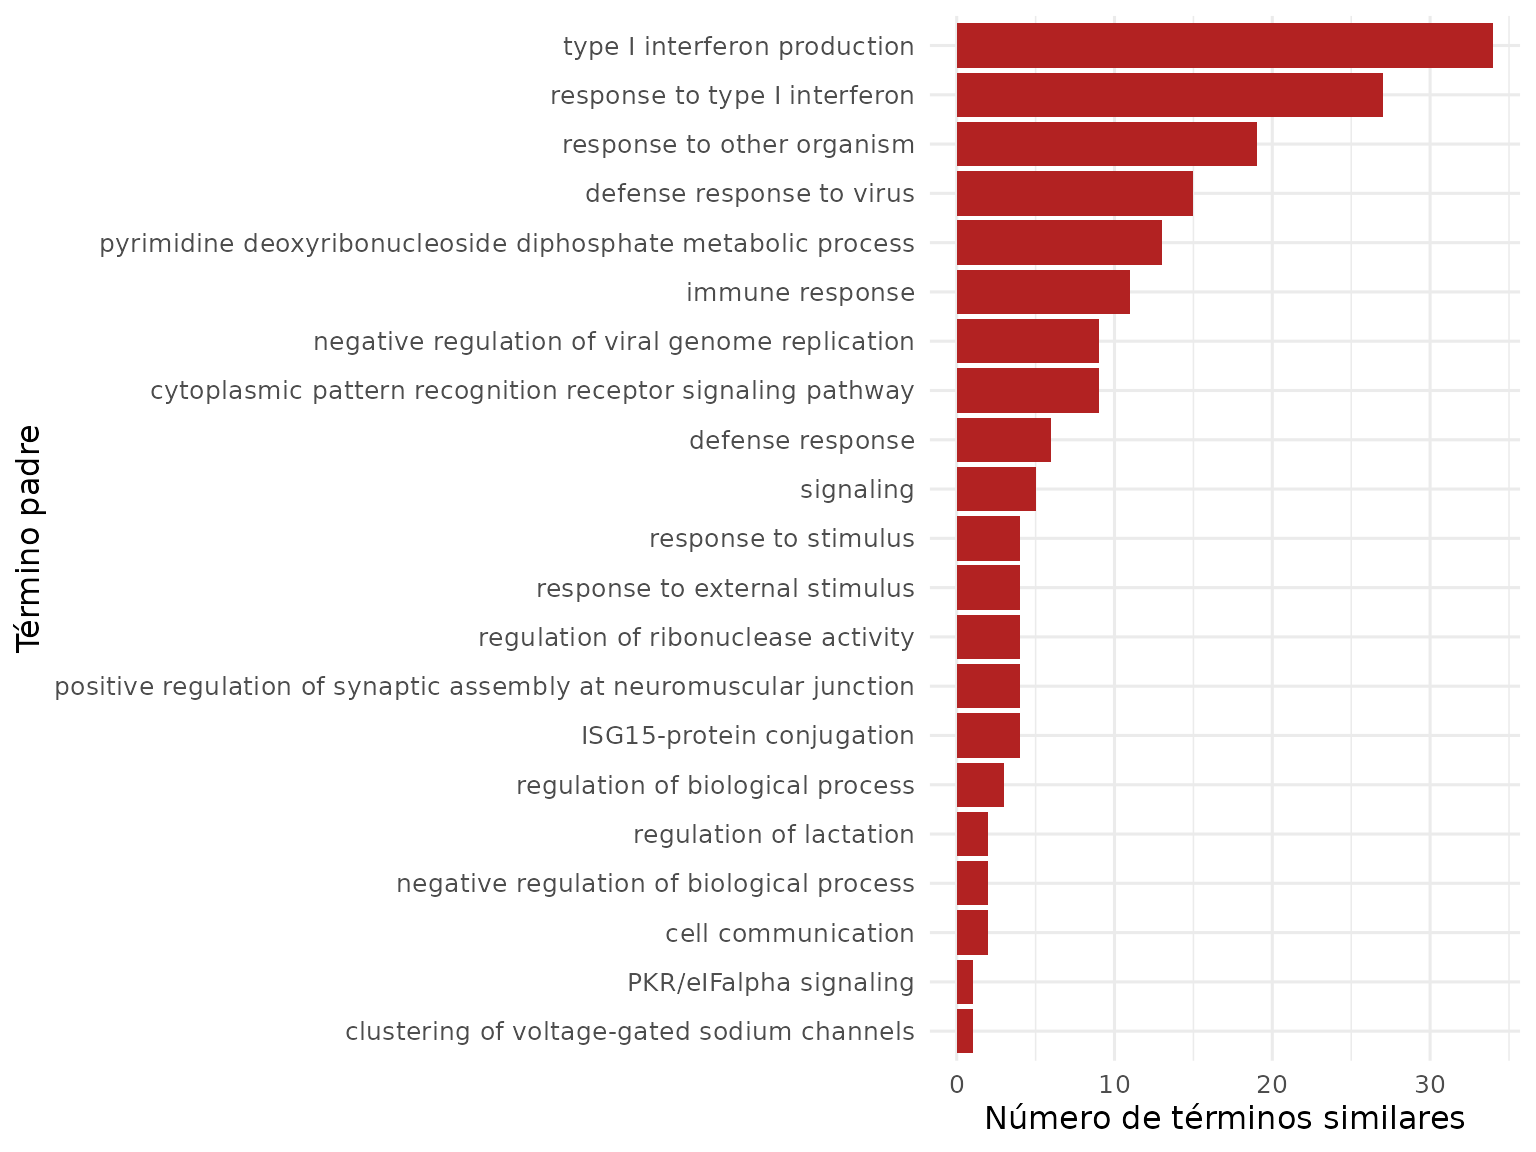
5. reduce_go_terms(): muchos archivos a la vez
Si tienes varias listas (por ejemplo, una por tipo celular y
dirección), guarda un archivo por lista en la misma carpeta y usa
reduce_go_terms(). La función busca todos los archivos
UP_GO_*.RData y DOWN_GO_*.RData y aplica
process_go() a cada uno:
lists <- c(DOWN_GO_moDC = "SLE_DOWN_moDC", UP_GO_tolDC = "SLE_UP_tolDC")
for (f in names(lists)) {
  go_table <- go_results %>%
    filter(query == lists[[f]], source == "GO:BP") %>%
    transmute(go_id = term_id, term = term_name, p.adjust = p_value)
  save(go_table, file = file.path(go_dir, paste0(f, ".RData")))
}
list.files(go_dir)
#> [1] "DOWN_GO_moDC.RData"   "UP_GO_monocyte.RData" "UP_GO_tolDC.RData"
reduce_go_terms(indir = go_dir, outdir = out_dir, figdir = fig_dir)reduce_go_terms() procesa los tres archivos y guarda sus
resultados con el mismo formato que process_go(). Cada
archivo tarda alrededor de un minuto, porque rrvgo calcula
la similitud entre todos los términos.
Reto 2. Ejecuta process_go() sobre el
archivo DOWN_GO_moDC.RData. ¿Cuál es el término padre que
agrupa más términos?
Ver solución
process_go(f = file.path(go_dir, "DOWN_GO_moDC.RData"),
          direction = "DOWN", outdir = out_dir, figdir = fig_dir)

load(file.path(out_dir, "reducedTerms_simMatrix_DOWN_moDC.RData"))
dplyr::count(reducedTerms, parentTerm, sort = TRUE) %>% head(3)
El término padre más frecuente es “T cell
activation”: los genes que bajan en las moDC de las pacientes
son sobre todo genes de linfocitos T (CD28,
CD40LG, ZAP70), como vimos en la lección
4.
6. Resumen
| Función | Entrada | Salida |
|---|---|---|
get_heatmap_mat() |
DESeqDataSet |
Matriz de z-scores (genes × muestras) |
create_heatmap() |
Matriz, color y split
|
Objeto Heatmap; se apila con %v%
|
process_go() |
Un archivo UP_GO_*.RData o
DOWN_GO_*.RData
|
Términos reducidos (.RData), treemap y barras
(.png) |
reduce_go_terms() |
Una carpeta con varios archivos | Lo mismo que process_go(), para cada archivo |
Errores comunes de principiante
-
Olvidar cambiar el diseño al tomar un solo tipo
celular:
~ Cell_type + Groupno tiene sentido si solo hay un tipo celular. -
Apilar heatmaps con columnas distintas:
%v%necesita las mismas columnas, en el mismo orden. -
Nombrar mal los archivos de GO:
reduce_go_terms()solo encuentra archivosUP_GO_<nombre>.RDatayDOWN_GO_<nombre>.RData. -
Guardar más de un objeto en el
.RData:process_go()espera exactamente una tabla por archivo.
Para volver a las lecciones, consulta Primeros pasos con el paquete GeneExprLupusMx.
↑ Volver a InicioInformación de la sesión
sessionInfo()
#> R version 4.6.2 (2026-10-29)
#> Platform: x86_64-pc-linux-gnu
#> Running under: Ubuntu 24.04.5 LTS
#>
#> Matrix products: default
#> BLAS:   /usr/lib/x86_64-linux-gnu/openblas-pthread/libblas.so.3
#> LAPACK: /usr/lib/x86_64-linux-gnu/openblas-pthread/libopenblasp-r0.3.26.so;  LAPACK version 3.12.0
#>
#> locale:
#>  [1] LC_CTYPE=C.UTF-8       LC_NUMERIC=C           LC_TIME=C.UTF-8
#>  [4] LC_COLLATE=C.UTF-8     LC_MONETARY=C.UTF-8    LC_MESSAGES=C.UTF-8
#>  [7] LC_PAPER=C.UTF-8       LC_NAME=C              LC_ADDRESS=C
#> [10] LC_TELEPHONE=C         LC_MEASUREMENT=C.UTF-8 LC_IDENTIFICATION=C
#>
#> time zone: UTC
#> tzcode source: system (glibc)
#>
#> attached base packages:
#> [1] grid      stats4    stats     graphics  grDevices utils     datasets
#> [8] methods   base
#>
#> other attached packages:
#>  [1] ggplot2_4.0.3               dplyr_1.2.1
#>  [3] ComplexHeatmap_2.28.0       DESeq2_1.52.0
#>  [5] SummarizedExperiment_1.42.0 Biobase_2.72.0
#>  [7] MatrixGenerics_1.24.0       matrixStats_1.5.0
#>  [9] GenomicRanges_1.64.0        Seqinfo_1.2.0
#> [11] IRanges_2.46.0              S4Vectors_0.50.3
#> [13] BiocGenerics_0.58.1         generics_0.1.4
#> [15] GeneExprLupusMx_0.1.0.9000
#>
#> loaded via a namespace (and not attached):
#>   [1] DBI_1.3.0            rlang_1.3.0          magrittr_2.0.5
#>   [4] clue_0.3-68          GetoptLong_1.1.1     gridBase_0.4-7
#>   [7] otel_0.2.0           compiler_4.6.2       RSQLite_3.53.3
#>  [10] png_0.1-9            systemfonts_1.3.2    vctrs_0.7.3
#>  [13] shape_1.4.6.1        pkgconfig_2.0.3      crayon_1.5.3
#>  [16] fastmap_1.2.0        XVector_0.52.0       labeling_0.4.3
#>  [19] promises_1.5.0       rmarkdown_2.32       ragg_1.5.2
#>  [22] bit_4.6.0            xfun_0.62            cachem_1.1.0
#>  [25] jsonlite_2.0.0       blob_1.3.0           later_1.4.8
#>  [28] DelayedArray_0.38.2  BiocParallel_1.46.0  cluster_2.1.8.3
#>  [31] parallel_4.6.2       R6_2.6.1             bslib_0.12.0
#>  [34] RColorBrewer_1.1-3   reticulate_1.47.0    jquerylib_0.1.4
#>  [37] GOSemSim_2.38.3      iterators_1.0.14     Rcpp_1.1.2
#>  [40] knitr_1.52           httpuv_1.6.17        Matrix_1.7-6
#>  [43] igraph_2.3.4         tidyselect_1.2.1     abind_1.4-8
#>  [46] yaml_2.3.12          doParallel_1.0.17    codetools_0.2-20
#>  [49] lattice_0.23-1       tibble_3.3.1         withr_3.0.3
#>  [52] shiny_1.14.0         KEGGREST_1.52.2      S7_0.2.2
#>  [55] askpass_1.2.1        evaluate_1.0.5       treemap_2.4-4
#>  [58] desc_1.4.3           xml2_1.6.0           circlize_0.4.18
#>  [61] Biostrings_2.80.2    pillar_1.11.1        foreach_1.5.2
#>  [64] NLP_0.3-3            scales_1.4.0         xtable_1.8-8
#>  [67] glue_1.8.1           slam_0.1-56          pheatmap_1.0.13
#>  [70] tools_4.6.2          tm_0.7-20            data.table_1.18.6.1
#>  [73] RSpectra_0.16-2      locfit_1.5-9.12      fs_2.1.0
#>  [76] umap_0.2.10.0        AnnotationDbi_1.74.0 colorspace_2.1-4
#>  [79] cli_3.6.6            rappdirs_0.3.4       textshaping_1.0.5
#>  [82] S4Arrays_1.12.1      gtable_0.3.6         yulab.utils_0.2.5
#>  [85] sass_0.4.10          digest_0.6.39        rrvgo_1.24.0
#>  [88] wordcloud_2.6        SparseArray_1.12.3   ggrepel_0.9.8
#>  [91] rjson_0.2.23         org.Hs.eg.db_3.23.1  farver_2.1.2
#>  [94] memoise_2.0.1        htmltools_0.5.9      pkgdown_2.2.1
#>  [97] lifecycle_1.0.5      httr_1.4.9           GlobalOptions_0.1.4
#> [100] GO.db_3.23.1         mime_0.13            openssl_2.4.2
#> [103] bit64_4.8.6